

Quanto costa un token: cinque strade, i conti e il punto di pareggio
Il dubbio che arriva sempre, prima di comprare una GPU o di sottoscrivere un'API: quanto costa davvero un token, e da dove lo prendo? La risposta non è una. Sono cinque strade, con costi, tetti e dipendenze molto diversi. Qui le mettiamo una accanto all'altra, coi numeri di oggi verificati sui listini ufficiali, e ti diciamo quando conviene noleggiare o possedere l'hardware invece di chiamare il frontier.
Il token, l'unità di conto
Ogni interazione con un modello si misura in token: pezzi di testo (parole spezzate) in entrata e in uscita. Un milione di token è circa 750.000 parole: una conversazione da qualche migliaio di parole è una manciata di migliaia di token. Chiunque ti vende intelligenza — una API, un provider, un server — lo fa in token (o, indirettamente, in secondi di GPU che producono token). Capire da dove arriva il token e quanto te lo costa è tutta la partita, perché il prezzo al token cambia di oltre cento volte a seconda della strada.
Via 1 — Il modello frontier in API
Chiami OpenAI o Anthropic e ricevi il loro modello più capace. È il tetto più alto che esista oggi: per il lavoro più duro, l'agente che fa in sequenza, la sintesi complessa, i modelli frontier restano davanti. Il prezzo è a token e riflette quel tetto. I listini OpenAI di oggi: la punta di gamma GPT-6 Astra a 10 dollari per milione di token in input e 50 in output; il gradino intermedio GPT-5.6 Terra a 2 e 12; il gradino ad alto volume GPT-5.6 Luna a 0,20 in input e 1,20 in output (verificati sul listino ufficiale). Anthropic segue la stessa logica con i suoi modelli Claude.
Cosa ottieni: il meglio, zero setup, scala illimitata. Cosa paghi oltre il prezzo: i tuoi prompt e i tuoi dati attraversano la rete e arrivano sul server del provider; la qualità e il prezzo possono cambiare quando lo decide il fornitore; e se il servizio si ferma, si ferma anche il tuo.
Via 1b — L'abbonamento, quando usi poco
Accanto all'API esiste il secondo modo di pagare il frontier: l'abbonamento mensile a ChatGPT o Claude. Plus costa 20 dollari al mese, Pro 100 o 200 a seconda del tetto di uso (listino ufficiale). La differenza è il modello di costo:
| Abbonamento (Plus) | API (GPT-6 Astra) | |
|---|---|---|
| Costo | 20 $/mese fissi | a consumo, zero se non usi |
| Volume incluso | ~160 messaggi ogni 3 ore | illimitato, pagato al token |
| 1.000 risposte/mese (~500 token ciascuna) | coperto dall'abbonamento | ~21 $ (Astra) · ~5 $ (Terra) |
| 10 milioni di token/mese | impossibile (tetti) | ~10–420 $ a seconda del modello (Luna → Astra) |
Il conto è semplice: un uso da persona (centinaia di conversazioni al mese) resta comodamente dentro i 20 dollari, mentre lo stesso volume in API costerebbe poco o niente. Ma appena il volume cresce — centinaia di migliaia di token al giorno, un servizio con tanti utenti — l'abbonamento si scontra coi tetti e l'API diventa di nuovo l'unica strada. L'abbonamento vince sull'uso leggero, l'API sull'uso pesante: non sono due offerte dello stesso prodotto, sono due fasce di domanda.
Via 2 — I provider di inferenza
Stessa comodità della API, ma su modelli aperti: Replicate, Modal, RunPod serverless. Carichi un modello open-weight (o uno a scelta dal loro catalogo) e paghi quando gira. Modal ti fa pagare al secondo: un H100 a 3,95 dollari l'ora, un A100 80GB a 2,50 (listino ufficiale). RunPod serverless ha la stessa logica con i worker che scendono a zero quando non servono: una RTX 4090 in serverless a 1,10 l'ora.
Il vantaggio rispetto al frontier è duplice: spesso modelli quasi uguali a un costo molto più basso, e modelli aperti che puoi anche scaricare e portarti a casa. Il limite è che stai ancora noleggiando: non possiedi nulla, e il dato passa comunque dal loro cloud.
Via 3 — Noleggiare l'hardware
Un gradino sotto: invece di chiedere token, prendi tu il server. Su RunPod e Vast.ai noleggi una GPU fatturata al minuto: una RTX 4090 a 0,34–0,74 dollari l'ora a seconda del tier (community senza SLA o secure con SLA), una H100 a 2,00–3,99. Su Vast.ai la versione interruptible costa oltre il 50% in meno ma può essere recuperata in qualsiasi momento; quella reserved blocca prezzi fino al 50% più bassi su contratti da uno, tre o sei mesi (listini ufficiali).
Qui cambia la natura del rapporto: il modello è tuo, gira su una macchina che hai in affitto, e i dati non finiscono in un'API di intelligenza. Paghi solo finché il server gira. Quando il carico è costante e grande, il noleggio diretto batte sia la API frontier sia il provider di inferenza, perché stai pagando GPU nuda invece di intelligenza a valore aggiunto.
Via 4 — Possedere l'hardware
L'acquisto: una GPU (o un Mac, o un mini-PC) e via. Il costo è una tantum — una RTX 4090 da 24GB si trova intorno ai 1.600 euro, una 3090 usata da 24GB sui 1.000 — più l'elettricità mentre gira. Nessun token da pagare, nessun minuto da fatturare: il modello è lì, sempre disponibile, e nessun byte dei tuoi dati lascia la casa o l'azienda.
È l'unica via in cui "sempre disponibile" è letteralmente vero: non dipende da una rete, da un fornitore, da un prezzo che può cambiare. Ed è l'unica in cui il dato non parte mai.
I numeri, messi in fila
Un esempio concreto: 20 milioni di token al mese (un po' di assistenza clienti, un po' di sintesi), con un mix realistico di 4 milioni in input e 16 milioni in output. Il calcolo è input ÷ 1M × prezzo input + output ÷ 1M × prezzo output (valori in euro, 1 $ = 0,92):
| Via | Calcolo | Costo al mese |
|---|---|---|
| API GPT-6 Astra | 4×10 + 16×50 | ~773 € |
| API GPT-5.6 Terra | 4×2 + 16×12 | ~184 € |
| API GPT-5.6 Luna | 4×0,20 + 16×1,20 | ~18 € |
| Noleggio 4090 (secure), 24 h | 0,74 $/h × 730 h | ~497 € |
| Noleggio 4090 (secure), 8 h al giorno | 0,74 $/h × 244 h | ~166 € |
| 4090 tua, 1.700 € | 1.700/36 mesi + luce | ~87 € |
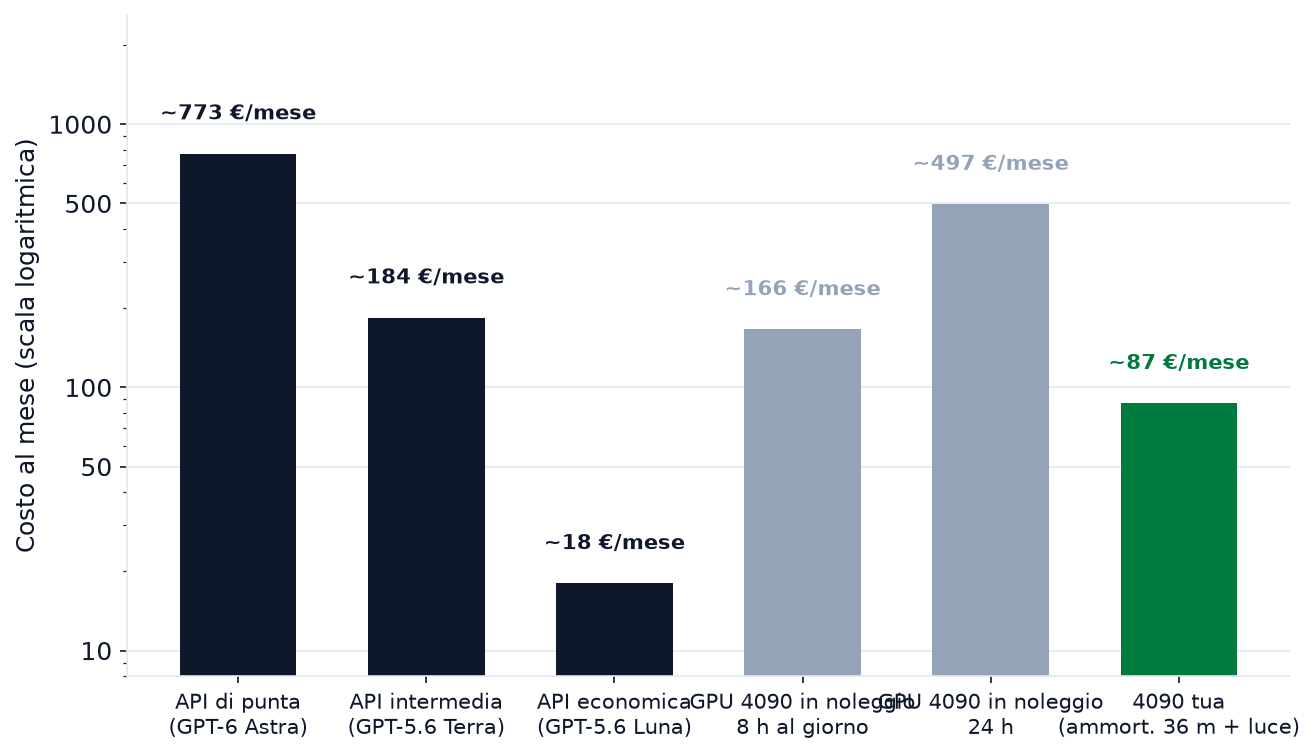
Il grafico dice la stessa cosa della tabella, solo in fretta: per lo stesso identico carico il prezzo varia da 18 a 773 euro, 40 volte. Non è un errore di stampa: stai comprando due cose diverse, il tetto di qualità e il rischio (il tuo, o del fornitore).
Quanto costa davvero l'elettricità
La voce più sottovalutata del possesso. Una macchina con 4090 sotto carico di generazione arriva a 350–450 W, più 100 W circa per il resto del sistema (CPU, RAM, dischi). A riposo con il modello caricato in memoria, 80–100 W. Il conto al mese, a 0,25 euro/kWh (tariffa base media italiana):
- 8 ore al giorno di lavoro (122 kWh in carica + 100 a riposo → 158 kWh): ~40 €/mese
- 18 ore al giorno (282 + 58 kWh → 265 kWh): ~66 €/mese
- 24 h su 24: 329 kWh → ~82 €/mese
La formula da tenere: watt ÷ 1000 × ore × tariffa, per le ore di carica più quelle a riposo. A 0,30 €/kWh (tariffa più alta) moltiplica per 1,2. Due note: la macchina consuma anche quando non generi (è per questo che a riposo col modello caricato conta), e un Mac con memoria unificata consuma una decima (30 W totali invece di 450), quindi la voce luce su un Mac è di fatto trascurabile.
Il ROI dell'hardware: quando si ripaga
Mettiamo in fila i costi cumulati su 36 mesi. Scenario: 4090 a 1.600 € + 100 € di accessoristica (1.700 € totali), ammortamento su 36 mesi, luce a 40 €/mese (uso quotidiano, 8 ore al giorno).
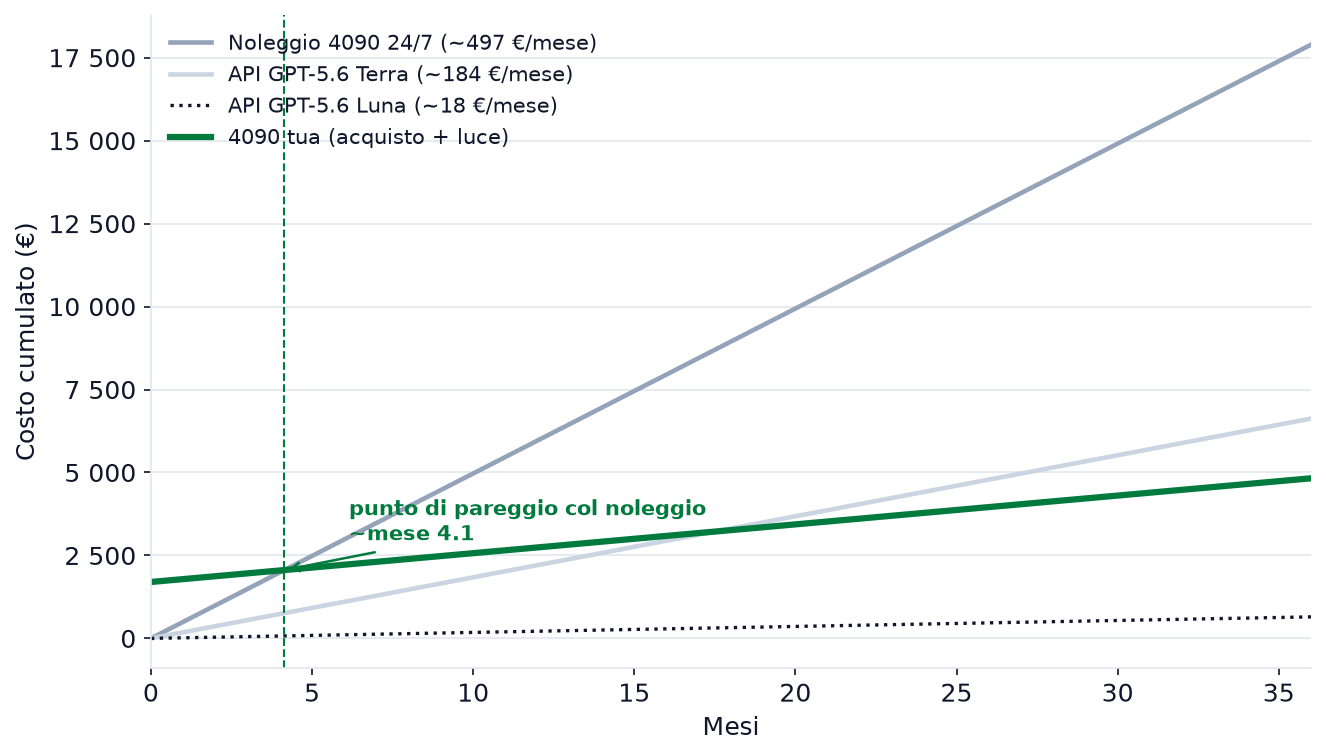
- Mese 1: hardware ~1.790 €, noleggio 24/7 ~497 €, API Terra ~184 €, API Luna ~18 €. Per i primi tre mesi la API resta la via più economica.
- Intorno al mese 4: il punto di pareggio col noleggio 24/7 (497 €/mese contro 87 €/mese + 1.700 € iniziali). Da qui in poi la curva dell'acquisto è la più bassa tra le vie con modello aperto, e la distanza si allarga mese dopo mese.
- Mese 36: hardware ~4.825 € totali contro 17.892 € di noleggio continuo, 6.624 € di API Terra, 27.828 € di API Astra.
Il punto di pareggio va calcolato col tuo carico: noleggio (€/h × ore/mese) contro ammortamento (prezzo ÷ mesi) + luce. Se il server gira più di 5–6 mesi, a parità di modello l'acquisto vince quasi sempre; se il carico è intermittente, il noleggio o la API economica restano avanti. E c'è la variabile qualità: se il tuo lavoro richiede davvero la punta frontier, l'hardware consumer non è un'alternativa, è un altro strumento — e la mossa economica è la mista, 90% del volume sul modello aperto e 10% sul frontier.
Dove vincono noleggio e possesso
Tre segnali che dicono "smetti di pagare il frontier": il tuo carico è costante (il server gira tanto, il noleggio diretto o il possesso battono la fatturazione a valore aggiunto); il modello che ti basta è aperto (a quel punto stai solo pagando una comodità che potresti togliere); e i dati devono restare tuoi (allora solo il possesso, e in seconda il noleggio, fanno al caso tuo). In questi tre casi il renting e l'hardware proprio non sono il piano B: sono il piano che costa meno e ti tiene il controllo in mano.
Come scegliere
- Uso leggero, personale: abbonamento — 20 $ al mese coprono centinaia di conversazioni.
- Prove, prototipi, carichi irregolari: API o provider di inferenza — parti da zero costi fissi.
- Carico costante, modello aperto, budget da rispettare per pochi mesi: noleggia la GPU diretta.
- Carico costante per più di sei mesi, dati sensibili, disponibilità 24/7: compra. È l'unica via senza dipendenze.
- Il lavoro più duro che esiste solo nel frontier: pagalo — ma solo quel pezzo, non tutto il resto.
La maggior parte dei carichi reali è un mix. La mossa che fa risparmiare è scomporli: il 90% del volume sul modello aperto (noleggiato o posseduto), il 10% del lavoro vero sul frontier. In quel mix, il token che conta di più — quello che produce valore — arriva dall'hardware che controlli tu. Se vuoi dimensionare il carico sul tuo hardware prima di decidere, parti dal Pianificatore di setup.
Fonti
- Prezzi OpenAI (GPT-6, GPT-5.6) — listino ufficiale
- Prezzi ChatGPT (Free, Go, Plus, Pro, Business) — listino ufficiale
- Prezzi Anthropic
- Prezzi Modal (GPU al secondo)
- Prezzi RunPod (community, secure, serverless)
- Prezzi Vast.ai (on-demand, interruptible, reserved)
- Confronto prezzi GPU cloud 2026
- Consumo reale RTX 4090 sotto carico di inferenza
- Consumo e costi hardware locale
Articolo generato con IA
In questi percorsi
Ti è piaciuto questo articolo?
Iscriviti alla newsletter per ricevere nuovi tutorial e guide.
Articoli Correlati
NVIDIA, AMD e Intel per l'IA locale: quale piattaforma scegliere
CUDA, ROCm o Vulkan? Confrontiamo le tre piattaforme per l'IA locale sulla base di ciò che è davvero disponibile: stack software ufficiali, schede per fascia di VRAM (12, 16 e 24GB) e velocità reali. Dove resta la scelta ovvia, dove AMD batte per rapporto qualità-prezzo e quando ha senso uscire da NVIDIA.
Qwen3.8-27B vs Gemma 4 26B A4B: la nuova frontiera a 24GB
Dense da 27,8B o MoE con 3,8B attivi, contesto da 262K contro 256K e quasi lo stesso peso in Q4_K_M: due modi opposti di portare la qualità da modello grande su una scheda consumer da 24GB. Chi va più in fretta, chi va più in profondità, e quando scegliere l'uno o l'altro.